11 月 3 日,硅谷老牌风投 Menlo Ventures 发布了今年的《企业 AI 现状报告》。
为了摸清企业今年到底花了多少钱,Menlo 委托 Morning Consult 在 9 月问了近 400 家美国企业的 AI 决策者,这些人经手的 AI 开支超过 40 亿美元。按 Menlo 的测算,截至今年 9 月,美国企业花在 AI 部署上的钱已经到了 1768 亿美元,是一年前 330 亿美元的 5.4 倍。
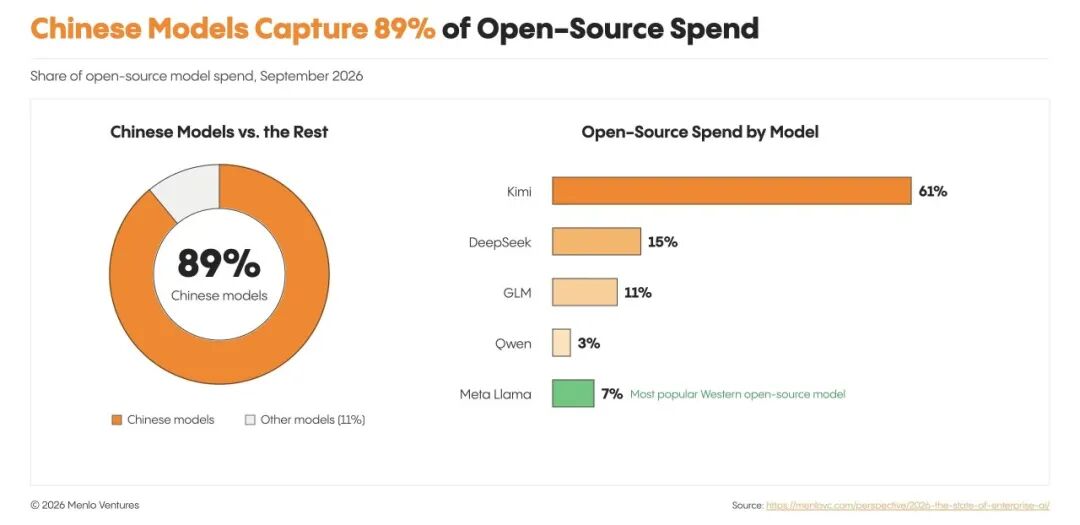
在这份写给硅谷看的报告里,有一组数字。美国企业花在开源模型上的生产开支,中国模型占了近九成。其中 Kimi 一家 61%,后面是 DeepSeek 15%、GLM 11%、Qwen 3%。西方开源模型里排第一的 Meta Llama,只有 7%。
写报告的 Menlo Ventures,是 Anthropic 的重要股东,2024 年领投了它 7.5 亿美元的 D 轮。
除此之外,把 Kimi 托管在服务器上卖给美国企业、今年年化收入刚刚突破 10 亿美元的头号推理云 Fireworks AI,是 Menlo 投的;每周处理 160 万亿 token 的模型路由平台 OpenRouter,是 Menlo 投的;报告专门点名、在 Kimi K2.5 上训出 Composer 2 的 Cursor,也是 Menlo 投的。
如果只看报告数据,你会觉得闭源巨头和开源阵营早该拼个你死我活,太平洋两岸的模型也该泾渭分明,但大人看利弊,小孩才分阵营。
除了这些数据、利益关系,动察 Beating 更想弄明白的是,为什么偏偏是 Kimi,成了美国企业在闭源旗舰之外最舍得掏钱的那个选项?
返工的价钱
要看懂 Kimi 的这个「61%」,得先了解今年美国企业在 AI 上花钱的怪癖,越便宜的模型,越没人用了。
过去两年,行业里最流行的判断是推理成本每年降九成,企业迟早会把工作流切到便宜的小模型上。各家实验室也确实把小模型越卖越便宜。
结果恰恰相反。
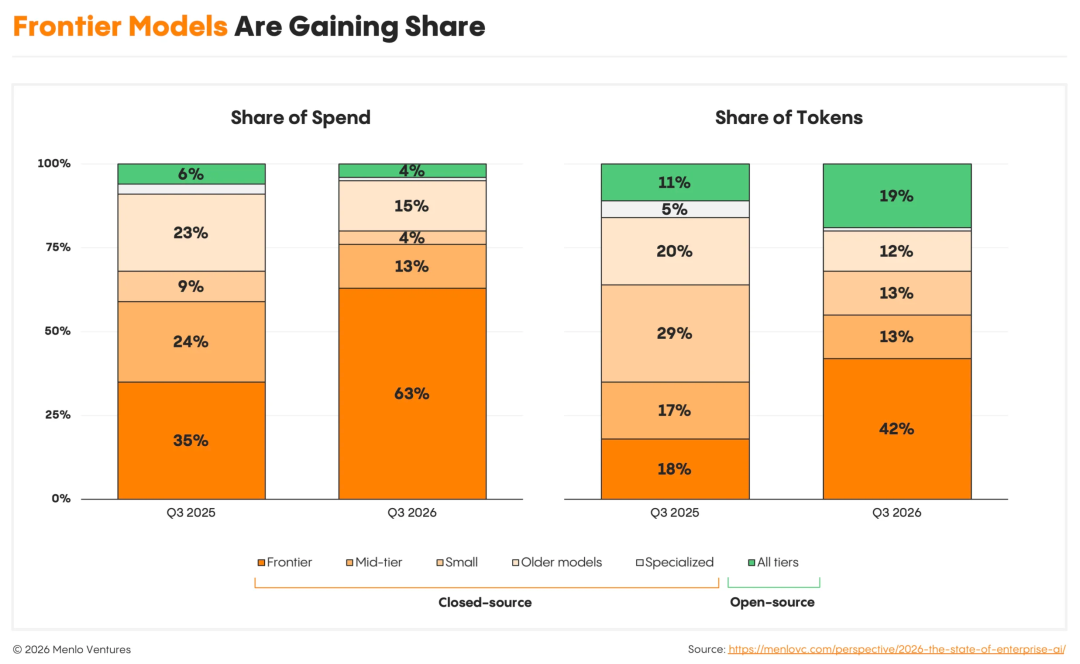
从 2025 年三季度到 2026 年三季度,Haiku、Luna 这类小型闭源模型在企业市场的 token 份额从 29% 掉到 13%,跌去一半还多。单价最贵的前沿旗舰,token 份额从 18% 涨到 42%,支出份额从 35% 涨到 63%。
一年前,美国企业最常用的主力还是输入 3 美元、输出 15 美元(每百万 token,下同)的 Claude Sonnet 4.5,和 1.25 美元、10 美元的 GPT-5。到了今年秋天,大家却排着队换成了更贵的旗舰模型。
精明的美国公司,为什么突然不图便宜了?
原因很简单,用模型干活的,从人变成了 Agent。
今年 2 月,OpenRouter 上由 Agent 发起的流量正式超过了人类;到 9 月底,平台上 80% 的 token 都是 Agent 在后台自己跑出来的,半年多涨了 37 倍。在 773 亿美元的企业 AI 应用支出里,76% 集中在编程和企业 Agent 上。
Agent 干活和人类使用 AI 不是一个逻辑。
一个编程 Agent 接下任务,往往要在代码库、终端和沙盒之间连跑四五十个回合:读文件、调工具、跑测试、看报错、再改代码。
长链条任务中,错误的代价是按乘法累积的。单步准确率 99% 的模型连跑 50 步,顺利交差的概率大约六成;换成单步 95% 的模型,50 步跑完不翻车的概率不到 8%。
于是企业很快就明白了,现在买模型看的不应该只是价目表上的挂牌单价了,更要看把事情一次办妥的总花销。
想通这一点,开源模型今年的处境也就好理解了。
过去一年,开源模型的 token 份额从 11% 涨到 19%,调用量是一年前的 22.5 倍;拿到的支出份额却从 6% 掉到 4%。原因是大多数开源模型卷进了价格战,平均单价跌到原来的三分之一不到,只剩每百万 token 0.13 美元,不到闭源模型综合均价的五分之一。
开源模型干了近五分之一的活,只从桌上分走了二十五分之一的钱。
Kimi 的 61%,恰恰是因为它没跳进 0.13 美元的陷阱里。
标准件
今年 7 月 16 日,月之暗面发布 2.8 万亿参数的 Kimi K3,官方 API 定价是输入 3 美元、输出 15 美元,和一年前的闭源旗舰 Sonnet 4.5 同价,也是上一代 K2.6 的三倍多。10 月 23 日推出的 K3.1 Pro 降到了 2 美元和 10 美元,仍然在旗舰档位。
在一个均价 0.13 美元的开源市场里按旗舰标价,底气首先来自模型本身在长上下文、原生多模态和编程上的成绩。
但光有跑分不够。
开源模型的权重是公开的,在推理云的下拉菜单里换一个模型,只需要改一行配置。美国企业的采购凭什么为它多付钱?
这里藏着开源模型走出实验室后最令人头疼的一个工程问题。
为了数据合规和延迟,大多数美国企业不会把代码和文档直接发往海外服务器,而是去买 Fireworks、Together 或亚马逊 Bedrock 这类本土云的托管服务。但在过去一年里,硅谷的工程团队频繁发现,某款开源模型在官方演示里聪明绝顶,可一旦接进自家的生产环境、走第三方推理云的接口调用,它在几十轮连续工具调用后就会莫名其妙地变笨。
原因就在于,推理云是一门极讲究显卡周转率的生意。一张卡同一秒钟能塞进多少个请求,直接决定了云厂商当季的毛利。为了省显存、抢吞吐速度,不同平台往往会在后台对万亿参数的 MoE 模型做不同的量化压缩,或者简化工具调用的解析模板。
平时聊天,这点精度缩水看不出来;放进几十步环环相扣的 Agent 循环,偏差就足够让模型选错专家、写坏格式,把整条工作流跑崩。
客户冲着模型的招牌买单,然后任务翻车,黑锅最后还得原厂来背。
Kimi 很聪明,它没有发声明去跟哪家云厂商掰扯,而是直接开源并持续运营一套供应商精度核验工具。
早在 K2 时期,它就开源了 K2 Vendor Verifier,用同一套测试去比对各家推理云和官方 API 在工具调用上的表现。今年 4 月发布 K2.6 时,这套工具升级为 KVV(Kimi Vendor Verifier),测试项包括长上下文下的工具调用回归样本、JSON schema 校验、对畸形调用的拒绝、百万 token 级的长记忆测试,以及 113 个编程 Agent 任务。各家推理云跑出来的成绩,以表格形式挂在 GitHub 上。
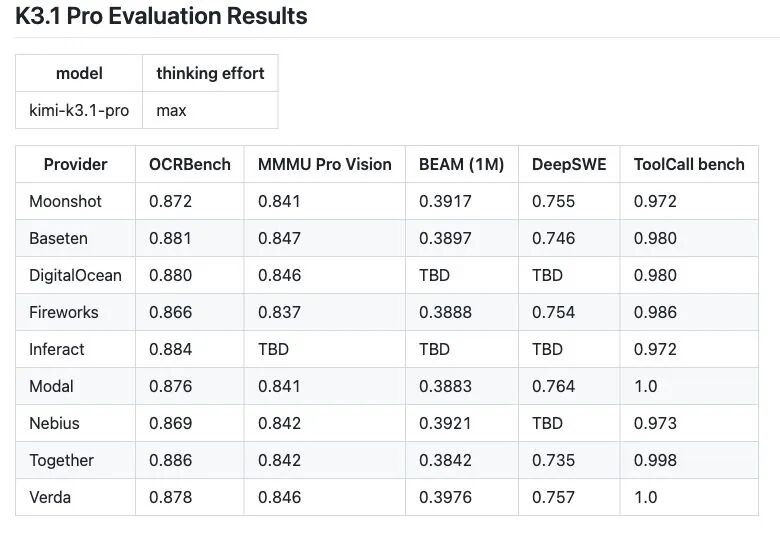
哪家云厂商为了省机器偷偷降了精度,开发者在看板上一眼就能看出来。
为了把 KVV 的分数对齐到 Kimi 官方 API 的水平,硅谷的推理云厂商不得不反过来找 Kimi 的工程师一起捉虫。
Fireworks AI 的工程团队后来专门发文复盘,讲他们如何联合 Kimi 团队修补底层解码护栏、清理多轮对话里的冗余字段,最终把托管接口的工具调用表现打磨到了原厂水平。
大多数团队做开源,是把权重往网上一放,剩下的看造化。月之暗面却把严苛的品控手腕搬到了开源世界里,我不收你的门票,但我得管着你怎么把菜端上桌。
这一下打在了企业采购最敏感的神经上。对硅谷的技术负责人来说,KVV 把散落在各家机房里的非标品,重新校准成了原厂认证的标准件。
四分之三
如果只有托管质量,Kimi 充其量是个好用的外援。报告里点到的另一个名字,揭开了它在海外的第二层价值,它就是 Cursor。
Menlo 写到,今年做后训练的 AI 开发者比例从 6% 涨到了 10%。最典型的案例,就是 Cursor 在 Kimi K2.5 上训出了 Composer 2,由 Fireworks 提供强化学习阶段的推理。
Menlo 的数据把独立应用公司的处境照得一清二楚,今年 1768 亿美元的企业 AI 支出里,Anthropic、OpenAI 和 Google 三家实验室拿走 1227 亿美元,占 69%,一年前是 50%。其中,实验室自家的应用就拿走了 400 亿美元。
单看 340 亿美元的编程赛道,Claude Code 和 Codex 两款产品吃下 240 亿美元,占了 70%。
应用公司越成功,越能帮上游证明这个市场足够大,而市场一旦被证明足够大,握着模型和算力的上游就越有理由亲自下场。继续只当二道贩子,迟早要被上游压死。
今年 1 月初,Cursor 内部开了一场被称为「War Time」,创始人 Michael Truell 要求全员加速自研模型。
可应用公司想往上走谈何容易,Cursor 手里有几百万程序员每天写代码、改文件、跑终端的真实交互轨迹,这是做强化学习最好的燃料,但它手里只有几万张 GPU,没有百万张卡,也没时间从头花大半年去训一个万亿参数的预训练底座。
除此之外,Cursor 开内部会的几天后,Anthropic 就收紧了规则,不再允许第三方编程工具用个人订阅账号登录调用。
唯一的活路,是去开源世界里借一副好身板,把好钢全部用在后半程的强化学习上。
3 月 19 日,Cursor 发布 Composer 2,定价输入 0.5 美元、输出 2.5 美元,正好是当时 Claude Opus 4.6 的十分之一。Cursor 的 Lee Robinson 后来说,最终模型消耗的算力里,只有约四分之一来自基座,剩下的都花在 Cursor 自己的训练上。
这改写了应用公司挑开源模型的标准。
以前大家挑开源模型,像挑一件买回家直接穿的成衣,谁在公开榜单上多考两分就选谁。但在 Cursor 随后公开的 46 页技术报告附录里,研究团队写道,他们在评估候选基座时,团队有意不看编程 Agent 类的跑分,理由是这类榜单对最终效果的预测力更弱,因为 Agent 和长程任务能力会在强化学习阶段被大幅改变。
不少模型为了发榜当天好看,在出厂前就已经塞满了针对特定题库的精调,权重空间被挤得像一块吸饱了水的海绵;外人看着分数高,可是买回来想往里再灌三倍的强化学习算力,模型很快就会出现能力坍塌。
Cursor 直接把候选模型拉到自家工地上试工。
他们只测三件事,底层的编码知识储备、一个文件被连续修改几十次之后的状态追踪能力,以及模型在 Cursor 私有大型代码库上的 perplexity。
测试之后 Kimi K2.5 留了下来。报告给的理由是综合表现强,以及在 Cursor 自己的基础设施上跑得够高效。经过持续预训练和强化学习,Composer 2 在 Cursor 自家的评测集 CursorBench 上从基座的 36.0 涨到 61.3,超过了 Claude Opus 4.6 的 58.2。
5 月,Cursor 又在同一个 K2.5 基座上推出了 Composer 2.5。
这段从春到夏的突围,给硅谷留下了一个样本,对最顶尖的应用公司来说,开放权重模型不再是省钱的平替,而是少数能拿过来、在上面继续砸钱训练自有资产的起点。
茶水钱
Cursor 把基于 K2.5 训出的 Composer 2 推给自己的用户,美国企业在生产环境里调用 Kimi,接住这些流量的,主要是 Fireworks、Together 这样的美国推理云。
把 Kimi、Fireworks 和 Cursor 摆在一起,能看到一种很有分寸感的分工。
换一家急于证明商业化能力的公司,看到自己的模型在硅谷受欢迎,第一反应往往是去旧金山租办公室,高薪挖一批企业销售,直接去敲美国大客户的门,把中间的差价全揣进自己兜里。
月之暗面没有这么干。
2025 年 7 月,Menlo 在年中报告里也写过,美国企业不愿意直接调用中国公司的 API,是开源模型份额停滞的原因之一。这道合规与信任的门槛,靠销售飞去加州磨破嘴皮子是跨不过去的。
与其硬撞那堵墙,不如把前面的肉让给美国本土的合作伙伴。Kimi 的工程团队在模型上线前后配合 Fireworks 等平台把推理引擎调顺,美国企业把合同签给美国云厂商,数据留在美国机房。
正因为月之暗面没有伸手去生意,Fireworks 才愿意卖力推 Kimi,Cursor 的工程师也才敢把当家产品建在 K2.5 的权重上。大家都有钱赚的时候,这事儿才能成气候。
至于月之暗面自己的收入问题,它把规矩写在了 K3.1 Pro 的许可证里。
企业内部部署、做研究,或者拿去微调做自己的产品,都不用打招呼。要坐下来谈的只有两种情况,一是拿它做模型托管,对外提供推理或微调服务,连续 12 个月收入超过 2000 万美元的,得先和月之暗面另签协议;二是终端产品月活过亿或月收入超过 2000 万美元,要在界面上明显地标出模型名。通过月之暗面官方产品或认证推理伙伴使用的,不受这两条约束。
8 月,路透社报道,月之暗面正在和微软、亚马逊、谷歌商谈 K3 相关服务的收入分成,要价最高 30%。
不到一个月,美国时间 9 月 18 日,亚马逊把 K3 放上了 Bedrock。全球标准档的价格和月之暗面官方一样,3 美元、15 美元,分成比例没有公开。
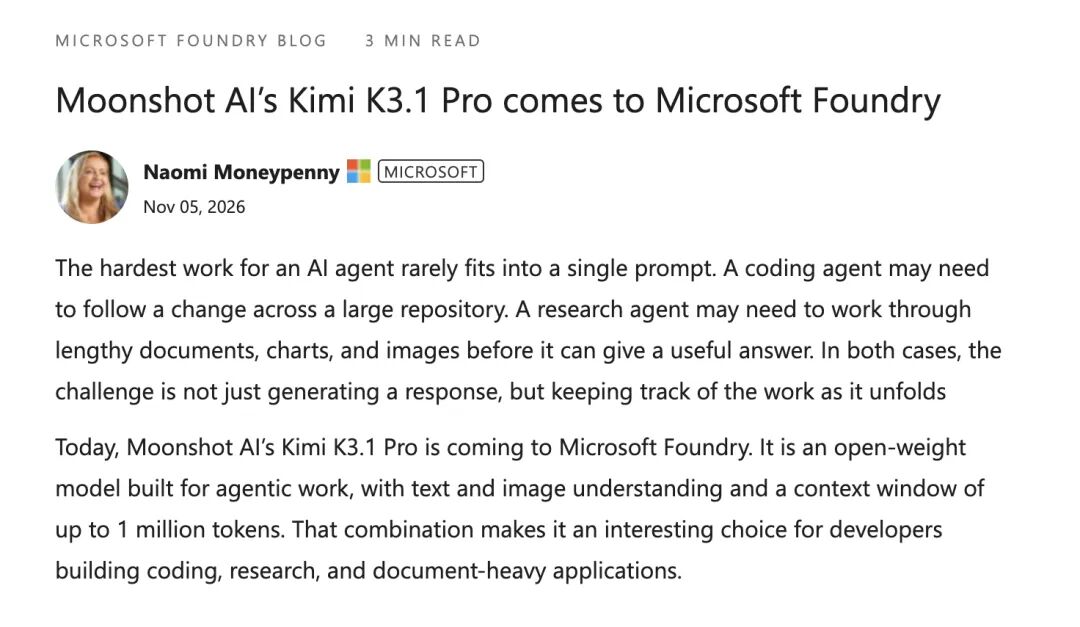
微软的路径绕一些。K3 在 7 月底就进了 Microsoft Foundry,但当时是 Fireworks 在背后跑推理,Foundry 只负责接入。美国时间 11 月 5 日,微软在自家博客上宣布 K3.1 Pro 正式上架 Foundry。
用老辈生意人的话讲,这叫小路随便走,大路交茶水钱。一百家里有九十九家还在试错的初创公司,Kimi 不收一分钱;等谁真跑成了一年几千万美元的大买卖,再按规矩坐下来谈。
清楚哪部分钱眼下不该自己赚,有时候比知道怎么赚钱更考验定力。
黑猫白猫
把视线从这 61% 的切面拉远一点,今年秋天的这组数据之所以耐人寻味,是因为它呈现了大模型产业在磨合三年之后,自然生长出的一种新关系。
两年前,硅谷关于行业终局的争论非黑即白,一派认为闭源旗舰会通吃一切,应用公司迟早沦为薄薄一层界面;另一派相信开源会把智能变成免费的自来水,让所有模型公司都赚不到钱。
到了 2026 年,两幅图景都没有成真。
Anthropic 和 OpenAI 依然拿走了美国企业大模型 API 支出的 86%。华尔街投行审一份跨国并购合同,药企做一次零容错的文献排查,依然会毫不犹豫地为最贵的闭源旗舰付费。流向开源的预算,也没有变成廉价算力的比拼场,反而向 Kimi 这样接近前沿的模型聚拢。
开源与闭源之间,不再是一道非此即彼的战壕。在复杂任务的催化下,两者之间长出了一片宽阔的交界地带。
在这片交界地带里,许多重度使用 Kimi 的硅谷公司,同时也是 Anthropic 和 OpenAI 的大客户。产品早期,它们用最强的闭源模型跑通形态、验证需求;等某条长链条工作流被验证成立、调用量开始指数级放大,或者像 Cursor 那样攒够了独有的交互数据、要把行业经验训进权重里时,它们就会转身去找那个离前沿最近、又允许自己深度改造的开放基座。
过去,模型公司和应用公司之间,一个卖 API,一个买 API 模型公司一旦自己做应用,双方立刻变成零和博弈的对手。
而现在,应用公司在开放模型上投入四分之三的算力继续训练,成了「半个模型公司」;模型开发者的影响力,也不再只看卖出了多少 token,还要看有多少别人的核心产品,是从它的权重里长出来的。
Menlo 报告发布的第二天,11 月 4 日,月之暗面按时在 Hugging Face 放出了 Kimi K3.1 Pro 的完整权重。按月之暗面自己公布的成绩,它在衡量编程 Agent 实战能力的 Terminal-Bench 4.0 上拿到 65.7%,高于 GPT-6 Astra 的 58.2%,离 Claude Opus 5.5 的 66.4% 只差 0.7 个百分点。
对把产品管线押在开源基座上的美国团队来说,这 0.7 个点,以及从 K2、K2.5、K2.6 到 K3、K3.1 Pro 每隔几个月就往前挪一步的节奏,比任何开源口号都让人安心。后训练出来的专用模型,每隔几个月就得跟着前沿重训一次。选一个基座,等于同时选了这家公司未来一年的迭代速度。
在旧金山,大概没有哪家创业公司会在路演 PPT 第一页写「我们的底座来自中国」,大模型的原产地依然是个敏感词。
可只要回到每天都在运转的服务器机房里,回到工程师盯着屏幕等 50 轮 Agent 循环跑通的深夜,所有的口号都会让位给实用主义。谁能抓到耗子,谁就是好猫。
当大洋彼岸的应用公司真正需要一个经得起折腾的伙伴时,抬起头,就能看见它早就站在那里。
